I. 문헌 정보
이번 포스팅에서는 대표적인 예측(prediction) 기반 이상 탐지 방법인 LSTM을 활용한 이상 탐지에 대해 알아본다. LSTM 기반 이상 탐지의 대표적인 논문인 Long Short Term Memory Networks for Anomaly Detection in Time Series (2015)의 내용을 참고하였으며, 그 외 참고 문헌은 글 아래에 남겨둔다.
(PDF) Long Short Term Memory Networks for Anomaly Detection in Time Series
PDF | Long Short Terma Memory (LSTM) Networks have been demonstrated to be particularly useful for learning sequences containing longer term patterns of... | Find, read and cite all the research you need on ResearchGate
www.researchgate.net
II. 이상 탐지 파이프라인
누적합 · 지수가중평균과 같은 확률적 통계치를 활용하는 전통적인 이상 탐지 기법에는 두 가지 문제점이 존재한다. 통계량 계산에 참조하는 타임 윈도우(time window, 이전에 말했던 구간 부분)의 길이를 사전에 정해줘야 한다는 점과, 해당 매개변수를 어떻게 설정해주느냐에 따라서 이상 탐지의 결과가 크게 달라진다는 점이다1.
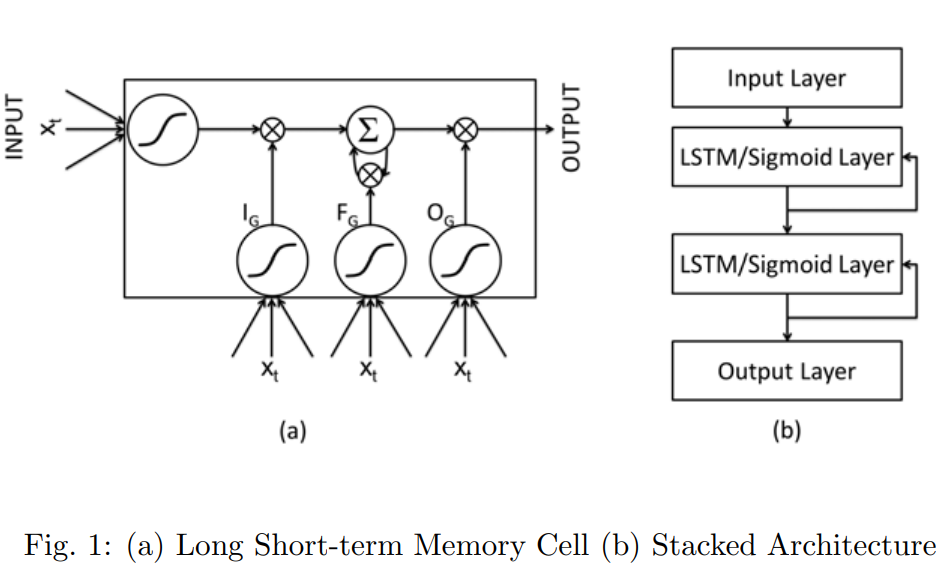
저자는 이러한 한계점을 극복하기 위해, 과거 입력 정보를 현재 입력과 함께 사용하여 시간적 관계를 학습할 수 있는 예측 모델인 순환 신경망(RNN)의 일종인 LSTM(Long Short Term Memory)의 순환 은닉층을 쌓은 적층 네트워크를 사용할 것을 제안하며, 이를 통해 사전에 고정된 윈도우나 전처리 없이도 정확한 이상탐지가 가능함을 보이고자 한다. LSTM은 과거 정보 가운데 필요한 정보는 유지하고 불필요한 정보는 제거하는 선택적 기억 구조를 통해 장기 상관관계를 학습할 수 있는 순환신경망 모델이다.
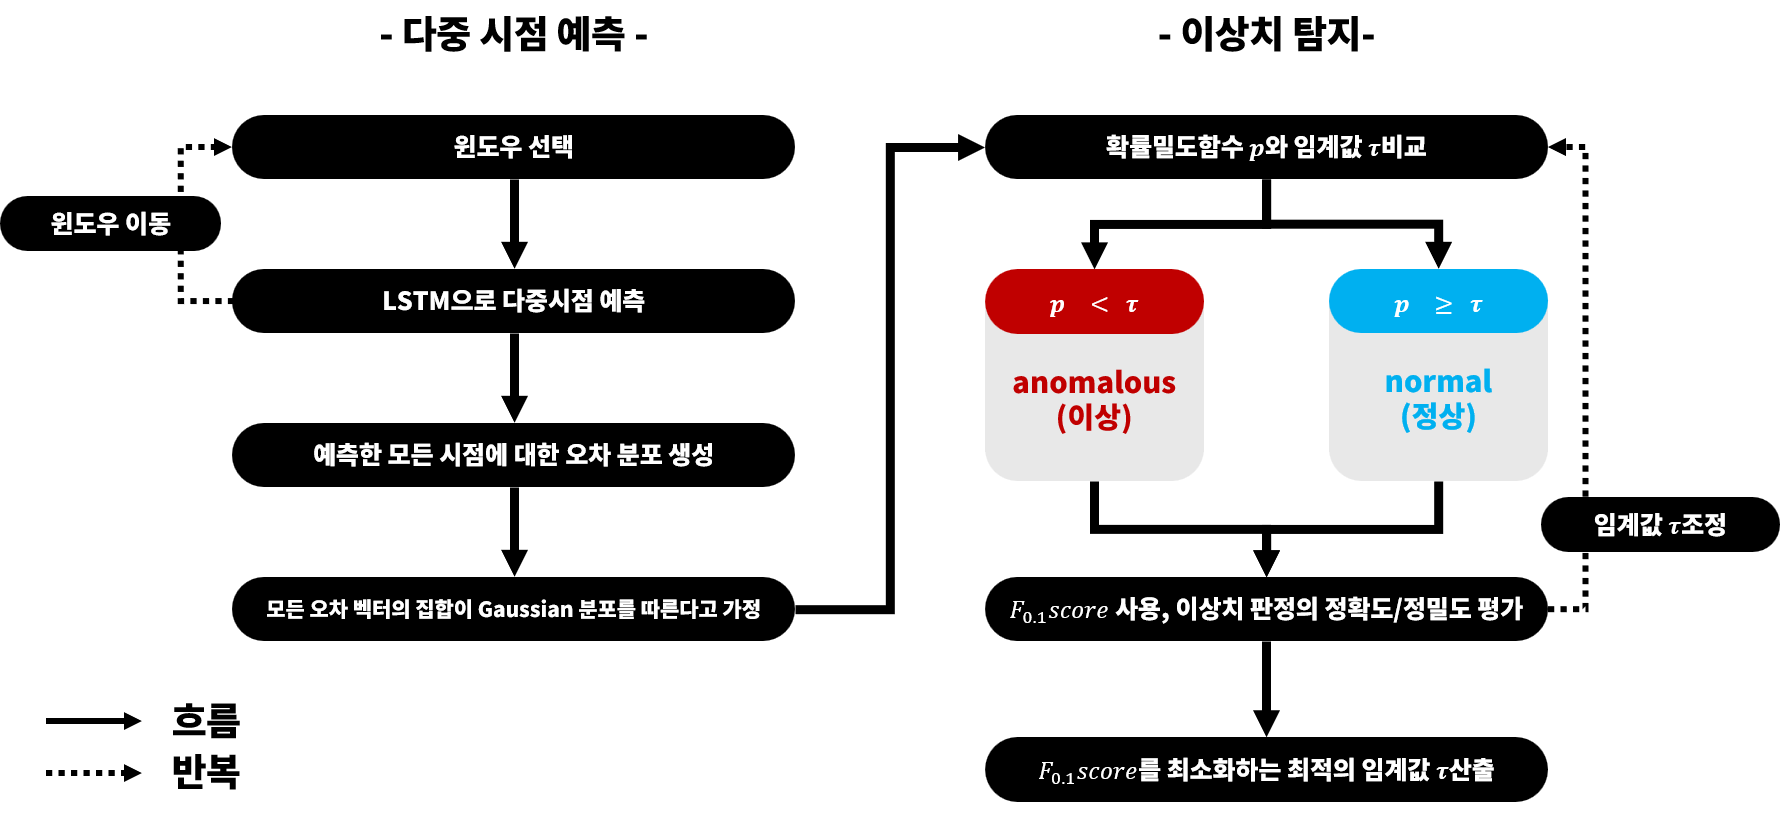
저자는 다음과 같은 이상 탐지 파이프라인을 제안한다. 정상 데이터로 LSTM 예측 모델을 학습시킨 뒤, 정상 데이터에서 발생한 예측 오차를 다변량 가우시안 분포로 모델링한다. 이후 테스트 데이터의 예측 오차가 정상 오차 분포에서 나타날 가능성이 임계값보다 낮으면 이상으로 판정하는 방식이며, 비교할 Baseline은 일반적인 RNN을 활용한 이상 탐지 결과이다.
III. 데이터 분할
원본 시계열을 다음과 같이 정상 · 이상 시퀀스로 분할하고, 다시 6가지 범주로 분할한다2. 분할 결과는 다음과 같다.
| 정상 시퀀스 | normal train ($s_N$) | LSTM 학습 |
| normal validation-1 ($v_{N1}$) | LSTM 학습의 조기멈춤 조건 | |
| 가우시안 분포 모델링 | ||
| normal validation-2 ($v_{N2}$) | 임계값 $\tau$ 조정 | |
| normal test ($t_N$) | 최종 평가 | |
| 이상 시퀀스3 | anomalous validation ($v_A$) | 임계값 $\tau$ 조정 |
| anomalous test ($t_A$) | 최종 평가 |
IV. 모델 학습 및 예측, 오차 분포 생성
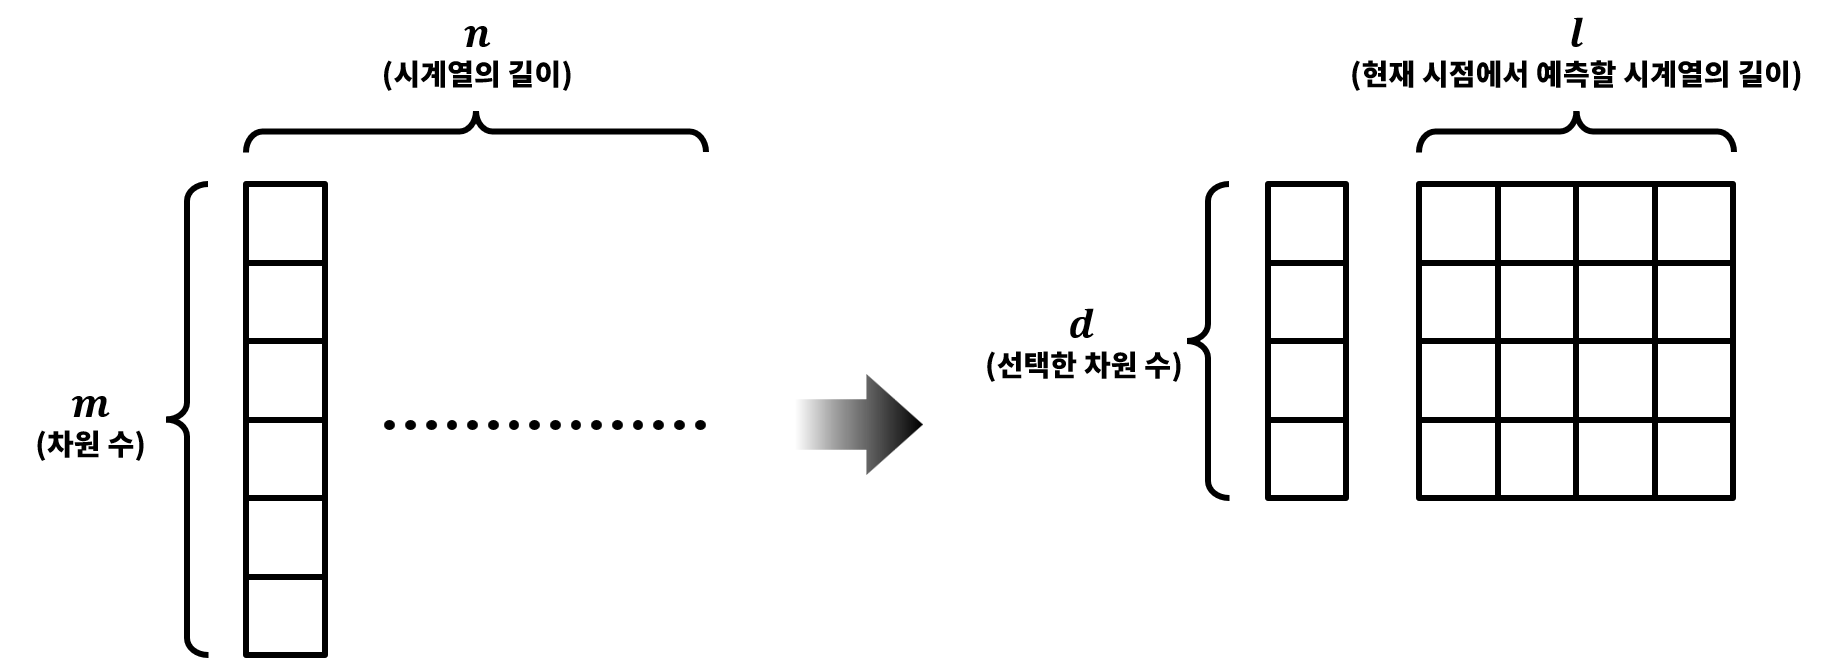
매 시점 $d$차원4의 데이터를 입력받아, 다음 $l$길이를 예측하는 LSTM 모델을 학습시킨다. 저자는 예측에 사용하는 적층 LSTM 모델의 구조를 아래와 같이 제시한다.
모델의 학습이 완료되었다면, 검증 · 테스트 데이터의 각 시점에 대해 예측을 수행하고, 실제 관측값과의 오차 벡터를 계산한다. 특정 시점 $x^{(t)}$에 대한 오차 벡터 $e^{(t)}$는 다음과 같이 얻어진다. 오차 벡터를 구성하는 $e_{ij}^{(t)}$는 해당 시점/차원에서의 실측 값인 $x_i^t$과 $t-j$시점에서의 예측 값 사이의 차이를 나타낸다.
$e^{(t)}=[e_{11}^{(t)},...,e_{1l}^{(t)},...,e_{d1}^{(t)},...,e_{dl}^{(t)}]$
V. 이상 탐지 및 임계값 $\tau$ 조정
본 논문에서는 오차 벡터를 다변량 가우시안 분포로 모델링하고, 오차 벡터 $e^{(t)}$가 가우시안 분포 내에서 발견될 가능성 $p^{(t)}$를 가우시안 확률밀도 값으로 정의한다. 즉, 해당 논문에서는 $p^{(t)}$가 이상 점수(anomaly score)를 의미한다고 보면 된다. 허나 저자는 모든 검증 · 테스트 데이터로 얻어낸 오차 벡터가 아닌, 정상적인 검증 데이터인 $v_{N1}$으로 얻어낸 오차 벡터만을 이용하여 가우시안 분포의 매개변수를 추정한다. 이는 정상 데이터에서 구한 오차 벡터의 분포를 기준으로 삼아, 새로운 오차 벡터가 기존 분포에서 얼마나 이례적인지를 평가하기 위함으로 추정된다.
새로운 관측 결과 $x^{(t)}$의 이상치 여부는 확률밀도함수 $p^{(t)}$와 임계값 $\tau$사이의 대소 관계로 판단한다. $p^{(t)}<\mu$일 경우 이상(anomalous)으로, 그렇지 않을 경우에는 정상(normal)으로 판단하게 된다. 이때, 최종적인 이상치 판정에 사용되는 $\tau$는 임의로 고정된(Fixed) 값이 아니다. $v_{N2}$와 $v_{A}$에서 계산한 $F_\beta-score$가 최대가 되도록 $\tau$를 최적화한 뒤, 이를 최종적인 이상 판정에 사용한다.
$F_\beta = \frac{(1+\beta^2)*precision*recall}{(\beta^2*precision)+recall}$
$F_\beta-score$는 정밀도(Precision)와 재현율(Recall)을 동시에 고려하는 예측 성능 측정 지표로, $\beta$에 따라 정밀도와 재현율 중 하나에 더 높은 가중치를 부여할 수 있다5. 본 논문에서는 $\beta=0.1$로 설정하여, 실제 양성으로 예측한 결과에 대한 정확도를 나타내는 정밀도6에 집중하는 모습을 보였다.
VI. 결과
저자는 총 4가지 데이터셋 (ECGs7, Space Shuttle Marmotta8, Power demand9, Multi-sensor engine10)에 대해서 이상 탐지 파이프라인을 수행하였으며, 그 결과를 다음과 같이 그래프와 표로 시각화하였다.
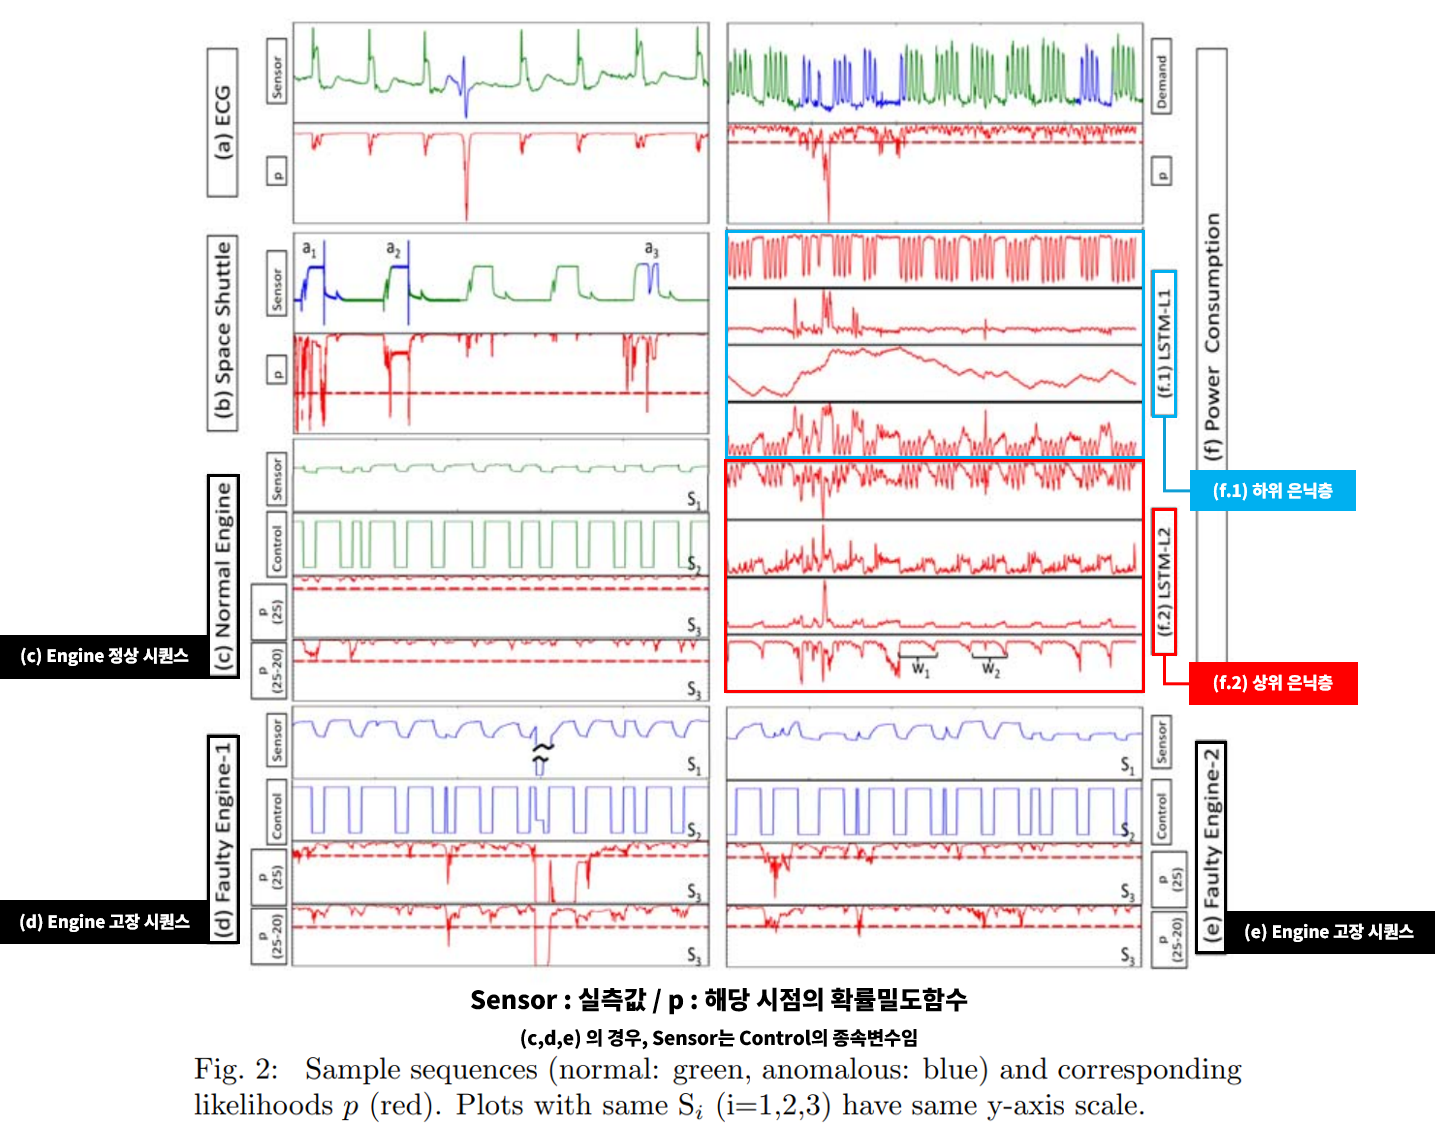
(f) Power Consumption 은 평일 5일(고점) + 주말 2일(저점)이 매주 나타나는 형태이다. 여기서 (f.1, f.2)는 적층 LSTM의 하위 · 상위 은닉층에서 각각 네 개씩 선택된 은닉 유닛의 활성화 값을 나타낸다. (f.2)의 $w_1$, $w_2$를 보면 평일에는 높은 활성화 값을, 주말에는 낮은 활성화 값을 보이는 것을 확인할 수 있는데, 이는 주(week) 단위의 장기적 특징을 잘 학습한 것으로 보인다.
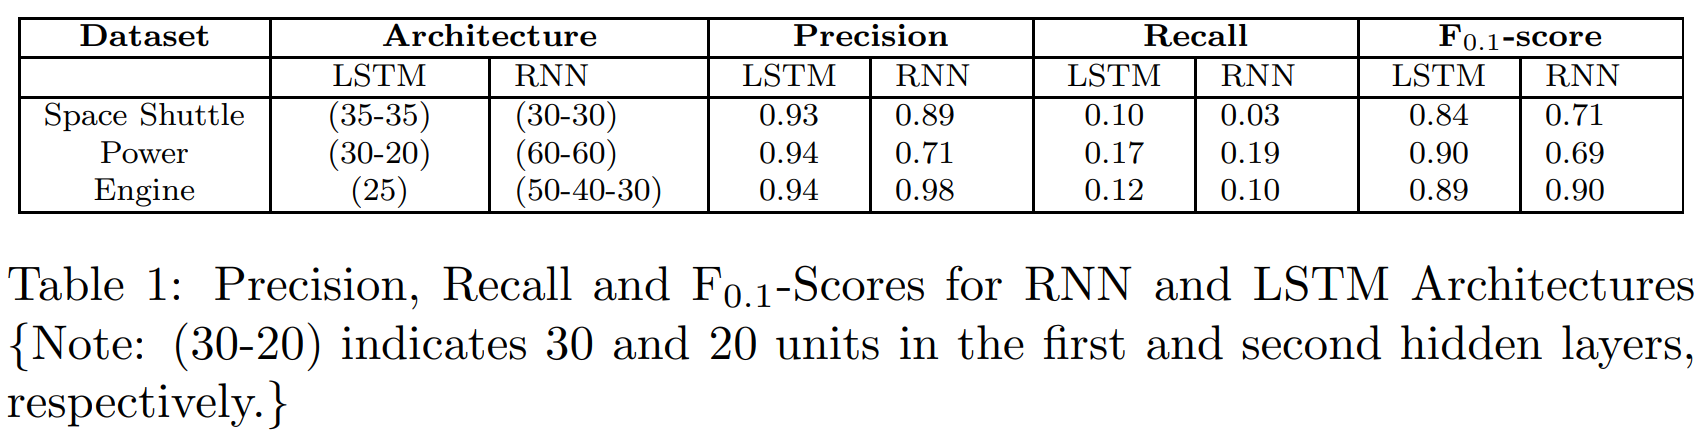
위 Table.1 에서 볼 수 있듯이, 장기적인 시간 의존성이 없는 Engine 데이터셋에서는 LSTM의 장기 기억 능력이 빛을 발하기 어렵기에, 두 모델이 비슷한 성능을 보였다. 하지만 장기 · 단기 의존성을 모두 포함하는 Space Shuttle · Power Demand 데이터셋에서는, LSTM 기반 모델이 RNN에 비해 $F_\beta-score$측면에서 각각 18% · 30% 향상된 성능을 보여주었다.
$LR^+=\frac{sensitivity}{1-specificity}=\frac{True Positive Rate}{False Positive Rate}$
또한, 별도의 시각화 자료가 존재하지는 않으나, 위와 같은 양성 가능도비(postivve likelihood ratio, $LR^+$)11를 모든 데이터셋에 대해 측정한 결과, 그 수치가 34.0 이상으로 높게 나타났다. $LR^+$값이 높다는 것은, 이상으로 판정한 관측값이 실제로 이상일 가능성이 높다는 것을 의미한다.
VIII. 결론
본 연구는 장기 의존성이 존재할 가능성을 배제할 수 없는 시계열의 이상치를 탐지하기 위한 방법으로, 순환 신경망의 일종인 LSTM을 활용한 논문이다. 정상 시계열의 단기 · 장기 시간적 패턴을 학습하여, 일반적인 RNN보다 우수하거나 유사한 성능으로 이상을 탐지할 수 있음을 확인하였다12.
다만 예측(prediction) 기반 이상 탐지 방법에는 이와 같은 예보(Forecasting) 기반 방법 뿐만 아니라, 복원(Reconstruction) 기반 방법 또한 존재한다. 따라서 다음 포스팅에서는 LSTM을 활용한 복원 기반 이상 탐지 방법을 알아보고자 한다.
<References>
[1] Malhotra, Pankaj, et al. "Long short term memory networks for anomaly detection in time series." Esann. Vol. 2015. No. 89. 2015.
[2] https://en.wikipedia.org/wiki/F-score (2026.08.23)
[3] https://www.openlayer.com/blog/precision-recall-machine-learning (2026.08.23)
[4] https://statisticsbyjim.com/glossary/positive-likelihood-ratio/ (2026.08.24)
- 윈도우가 너무 짧으면 노이즈에 민감해지고, 반대로 윈도우가 너무 길어지면 이상값이 다수의 정상 관측값에 희석되는 문제가 발생할 수 있다. [본문으로]
- [1] 2절 참조. [본문으로]
- 정확히 말하자면, 이상이 '포함된' 시퀀스를 뜻함. [본문으로]
- 예측할 특징의 수에 해당한다. [본문으로]
- [2] F-score [본문으로]
- [3] Precision and Recall in Machine Learning (Jan 2026) [본문으로]
- 심전도 데이터셋. 이상치가 단 하나만 존재하는 관계로, 해당 데이터셋에 대해서는 $\tau$와 $F_\beta-score$를 계산하지 않고, 이상치 시점에서의 $p^{(t)}$가 정상 구간보다 현저히 낮다는 것만 보여주고 있다. [본문으로]
- 우주왕복선 엔진의 밸브 시계열 데이터셋. [본문으로]
- 전력 수요 데이터셋. [본문으로]
- 12개 센서의 측정값으로 구성되는 데이터셋. 엔진의 제어 입력을 측정하는 센서와, 온도를 비롯한 종속 변수를 측정하는 센서들로 이루어진다. 본 논문에서는 제어(Control)센서 하나와 종속 변수 하나를 함께 선택하였다. [본문으로]
- [4] Positive Likelihood Ratio [LR+] [본문으로]
- [1] 4절 참조 [본문으로]
'지식창고 > anomaly detection (이상치 탐지)' 카테고리의 다른 글
| [anomaly detection] 시계열 이상 탐지란? (0) | 2026.08.07 |
|---|