I. 이상 탐지의 정의와 특징
이상치(Anomaly)는 명확하게 정의된 정상적인 행동의 개념에 부합하지 않는 데이터 내의 패턴1을 뜻한다. 즉, 예상되는 행동에서 벗어난 관측값 또는 패턴으로 보면 된다. 이러한 비정상 패턴은 응용 분야에 따라 outlier, exception 등 다양한 용어로 불리지만, 본 포스팅에서는 anomaly로 통일하여 지칭한다.
앞으로 이어질 포스팅에서는 관련 연구 사례를 바탕으로 시계열 데이터의 이상 탐지 방법에 대해 살펴볼 예정이다. 첫 글인 이번 포스팅에서는 이상치의 정의와 주요 특성을 정리하고, 시계열 이상 탐지의 핵심 개념에 대해 알아본다.
참조한 주요 문헌은 이상 탐지에 대한 전반적인 조사(survey) 논문인 [1]2, 그리고 시계열 이상 탐지 분야에 대한 리뷰 논문인 [3]3이다.
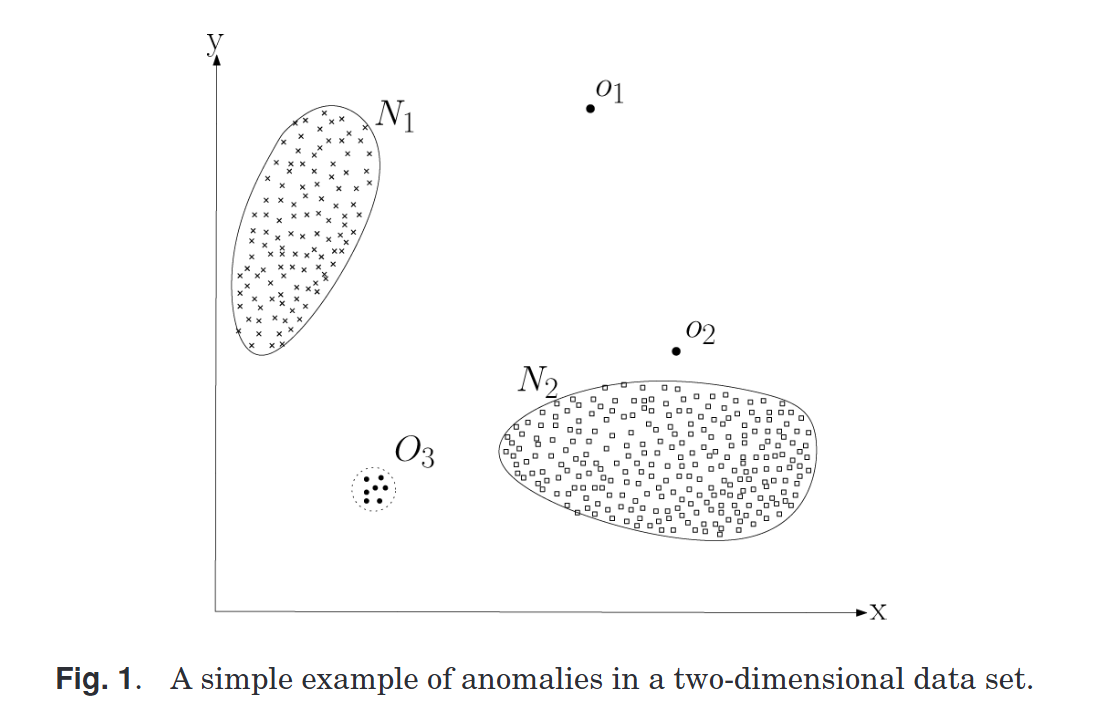
이상치는 다음과 같이 세 종류로 분류된다4.
점 이상(Point Anomalies)
특정 데이터포인트가 나머지 데이터와 비교했을 때 현저하게 동떨어져 있는 경우를 의미한다. 가장 단순한 형태의 이상이며, 이상 탐지 연구에서 가장 널리 다루어져온 유형이기도 하다. Fig.1 에서 점 $o_1, o_2$과 영역 $O_3$내부의 점이 Point Anomaly에 해당된다. 시계열 도메인에서는 시점(time point)의 관측값이 정상적인 범위를 벗어나는 경우를 의미한다. 어느날 오후, 평균적으로 10명 내외의 손님이 방문하는 식당에 30명이 넘는 손님이 왔다던가 말이다.
맥락 이상(Contextual Anomalies)
추세나 계절성과 같은 맥락 정보를 고려하였을 때, 동일한 맥락에 속한 다른 데이터와 비교하여 현저히 다른 데이터포인트를 뜻한다. 예를 들어 연평균 기온이 12.5℃인 지역에서 한겨울에 13℃가 관측되었다고 가정하자. 이 값은 전체 데이터의 평균과 크게 차이 나지 않으므로 Point Anomaly로 분류되지 않을 가능성이 높다. 그러나, 영하를 넘나드는 겨울철의 일반적인 기온 분포와 비교하면 이례적으로 높은 값이므로, 계절적 맥락을 고려하였을 때 Contextual Anomaly에 해당된다.
집단 이상(Collective Anoamlies)
개별 데이터 포인트만으로는 이상으로 판단하기 어렵지만, 연속된 데이터가 형성하는 패턴 전체를 고려했을때 비정상적인 경우를 의미한다. 예를 들어 맥박 측정값이 일시적으로 0을 나타내는 경우 센서 오류나 측정 누락으로 인한 결과일 가능성이 있어 정상으로 판단할 여지가 남아있지만, 이러한 값이 일정 시간 동안 연속적으로 나타난다면 측정 장치의 고장이나 심각한 이상 상태를 나타내는 Collective Anomaly로 판단될 수 있다.
II. 시계열 이상 탐지 파이프라인
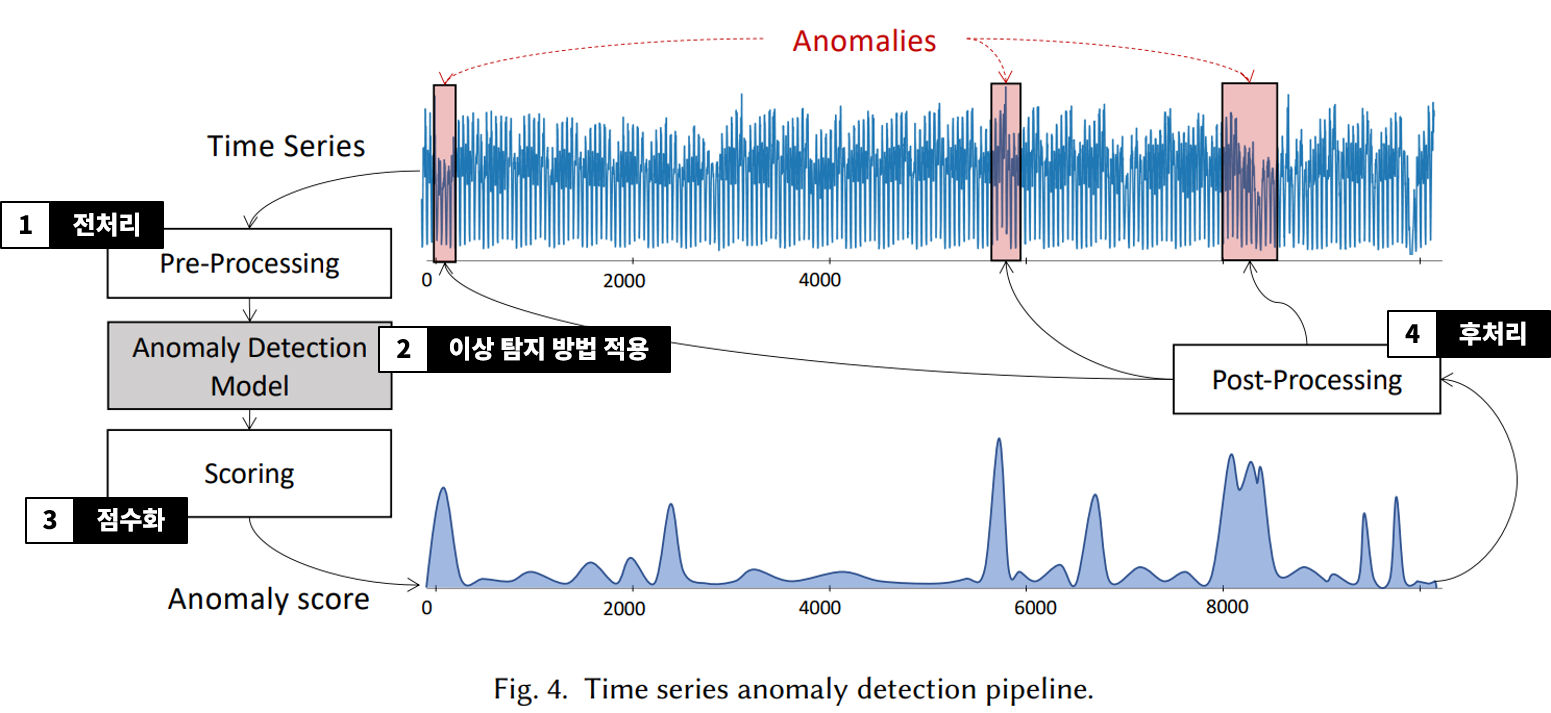
이제 시계열 도메인에서의 이상 탐지로 넘어가보자. 시계열 이상 탐지는 보통 다음과 같은 4-Step을 거치게 되는데5, 시계열 데이터는 개별 관측값뿐만 아니라 시간적 순서와 주변 맥락을 함께 고려해야 하므로, 전처리 단계에서 연속된 관측값을 구간 단위로 변환하는 과정이 필요하다.
1. 전처리(Pre-Processing)
구간 단위의 이상 탐지가 가능하도록 원본 시계열을 여러 부분 구간(sub-sequences)으로 잘라내는 윈도우 변환(window transformation)작업을 수행한다. 통계적 특징 추출이나 예측 모델 학습과 같은 기타 작업 또한 포함한다.
2. 이상 탐지 방법 적용(Anomaly Detection Model)
처리된 데이터에 다양한 이상 탐지 방법을 적용한다. 여기서 적용되는 방법론에 대해서는 후술.
3. 점수화(Scoring)
이상 탐지로 만들어진 결과를 이상 점수(anomaly score)로 변환한다. 이상 점수는 각 부분 구간이 얼마나 이상치에 가까운지를 실수 값으로 나타내는 평가 함수로, 각자의 방법론에 따라 다르게 정의된다. 얻어낸 이상 점수를 활용하여 개별 시점의 이상 점수를 추론하게 되며, 이상 점수화 된 시계열은 원본 시계열과 길이가 동일하다.
4. 후처리(Post-Processing)
이상 점수화된 시계열에서 이상 시점/구간을 추출한다. 주된 방법으로는 임계점(임계값, threshold)를 활용하는 방법이 있는데, 이는 임계점으로 지정한 이상 점수를 초과하는 시점들을 이상으로 간주하는 방식이다.
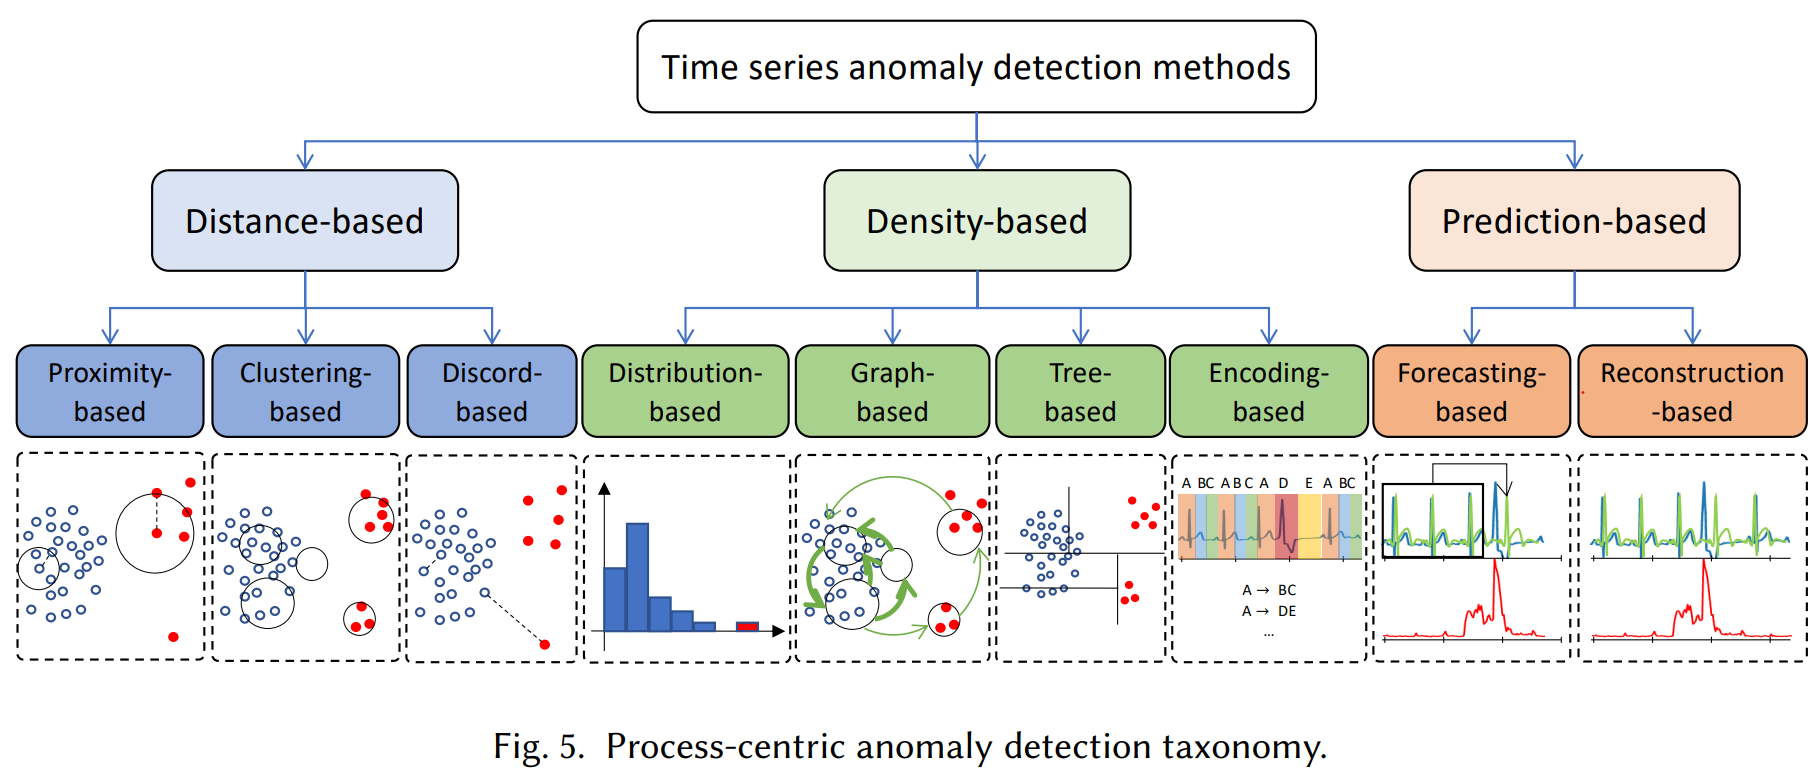
상술한 파이프라인의 Step.2 에서 적용되는 이상 탐지 방법은 크게 세 범주로 나뉜다6. 원본 시계열에 거리 척도를 그대로 적용하여 이상을 탐지하는 거리 기반(distance-based) 방식과, 분포와 같이 데이터의 밀도를 측정할 수 있도록 구성된 표현을 바탕으로 드물게 발견되는 패턴을 탐지하는 밀도 기반(density-based) 방식, 그리고 주어진 부분 구간을 학습 데이터로 활용하여 정상 시계열을 예측함으로써 이상을 탐지하는 예측 기반(prediction-based) 방식으로 말이다.
한 가지 유의할 점은, 세 범주에서 파생되는 9가지 하위 범주가 서로 배타적이지 않다는 것이다. 실제 이상 탐지 방법은 여러 처리 전략을 결합할 수 있으므로, 하나의 방법이 둘 이상의 하위 범주에 동시에 해당될 수 있다. 예를 들어, 예측 오차를 가우시안 분포로 모델링하여 이상을 판별하는 과정은 밀도/예측 기반 처리 방식을 결합한 사례이다. 해당 방법이 사용된 예시7에 대해서는 다음 포스팅에서 알아본다.
거리/밀도/예측 세 가지 방법 중에서도 가장 주목 받는 것은 예측 기반 방법이다. 논문 [3]에 따르면 2016년 이후, 제안된 이상 탐지 방법론의 수가 크게 증가하였으며8, 그 대부분이 예측 기반 접근법에서 비롯되었다고 제시한다. 저자들은 CV분야에서 딥러닝이 거둔 성공과 다양한 오픈소스 딥러닝 라이브러리의 등장이 이러한 추세에 영향을 미쳤다고 설명한다.
따라서, 앞으로 알아볼 시계열 이상 탐지 방법은 예측 기반 접근법에 집중하도록 하겠다.
III. 예측 기반 접근법을 통한 시계열 이상 탐지
예측(prediction)이라고 하면, 정답 라벨을 학습에 활용하는 지도학습을 떠올리기 쉽다. 주어진 정상/이상 라벨을 이용해서 학습시키고, 모델로 하여금 직접 이상 여부를 직접 예측하도록 하는 방식을 말이다. 그러나 이러한 지도학습 방식을 이상 탐지에 적용하기에는 분명한 한계가 있다.
지도학습을 적용하기 위해서는 전문가가 탐지하려는 패턴의 유형을 정확히 알고 있고, 이상 구간이 라벨링된 시계열 데이터가 확보되어 있어야한다. 하지만, 이상 탐지 전반에서는 일반적으로 이상 데이터가 정상 데이터보다 희소하다는 가정이 전제된다9. 이상 사례 자체가 적은 데다 전문가가 데이터를 일일이 검토해야 하므로, 충분한 라벨 데이터를 확보하는 데에는 상당한 비용이 발생한다10.
이러한 이유로 예측 기반 이상 탐지는 주로 비지도 또는 준지도 방식으로 수행된다. 실제로, 논문 [3]이 검토한 예측 기반 방법들은 모두 비지도 또는 준지도 방식에 해당한다11. 비지도/반지도 기반 이상 탐지 방식의 차이점은 다음과 같다.
비지도(Unsupervised)
정상 여부를 모르는 혼합 데이터에서 정상이 대부분이라고 가정하고 이상을 탐지하는 방식으로, 별도의 정상 · 이상 학습 데이터를 요구하지 않는다.
준지도(Semi-supervised)
전문가가 정상이라고 표시한 부분만 학습하는 방식으로, 대부분의 이상 탐지 방법이 사용하는 전형적인 방법이다.이상 라벨은 사용하지 않지만, 정상으로 라벨된 데이터만 사용했다는 점에서 준지도학습이라 불리운다.
※ 준지도 이상 탐지 방법도 문헌에서는 종종 'Unsupervised' 로 표기된다. 이는 정상/이상 라벨을 학습 목표로 직접 사용하지 않는다는 관행적 표현으로, [1,3]의 분류 기준과는 다르다는 것을 알아두자.
결국, 예측 기반 방법은 이상이 포함되어 있을 수도 있고 포함되어 있지 않을 수도 있는 데이터를 바탕으로, 예상되는 정상 행동을 예측하여 이상을 탐지하는 방법이다12. 다만, 정상 데이터는 비교적 쉽게 예측할 수 있지만 이상 데이터는 예상이 어렵다는 가정 하에 가능한 방법이기 때문에... 학습 데이터에 이상이 없거나 매우 적을 때 성립하는 방법이라는 것은 알아두도록 하자.
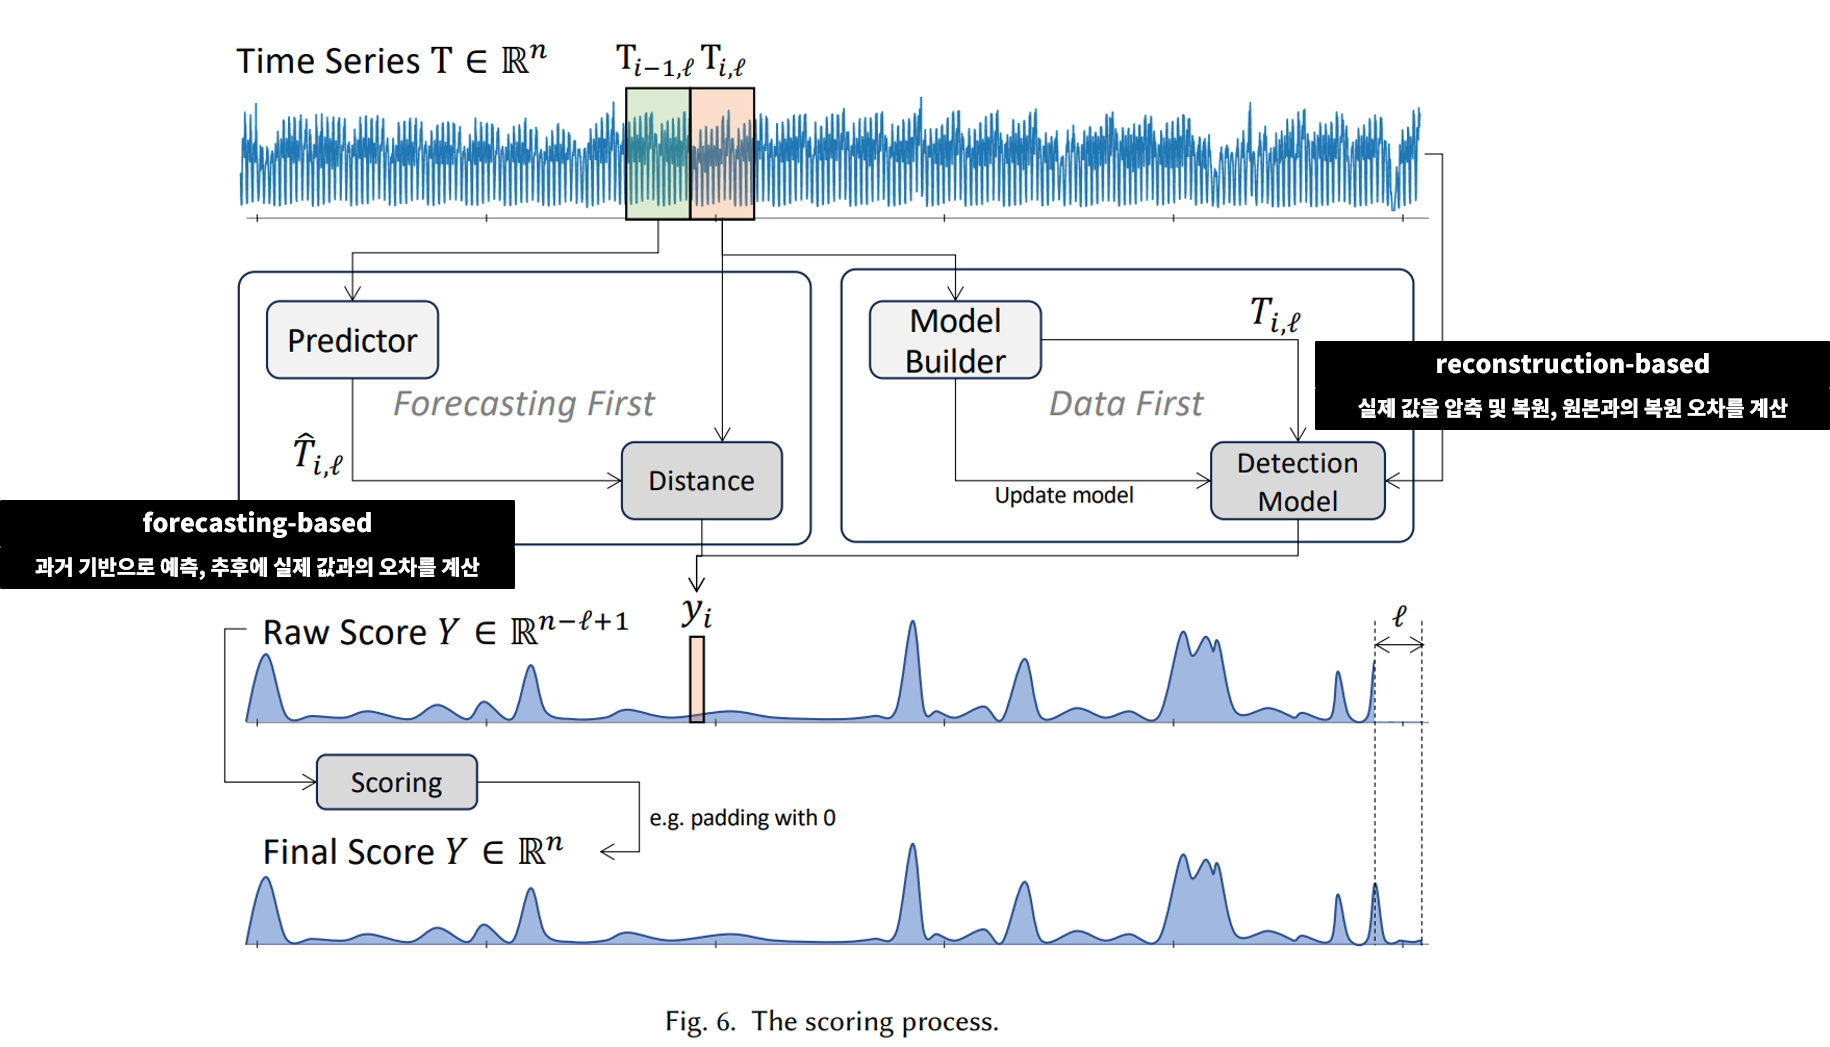
예측 기반 방법은 다시 두 가지 하위 범주인 예보(forecast)와 복원(reconstruction)으로 나뉜다13. 두 범주에 대한 자세한 내용은 추후 포스팅에서 다루도록 하고, 간단하게 정의만 짚고 넘어가도록 하겠다.
예보 기반(forecasting-based)
특정 시점 이전의 구간 $T_{i-1,l}$을 입력받아, 다음 구간 $T_{i,l}$을 예측한다. 예측 값과 실제 값의 차이인 예측오차를 이상 점수로 사용하며, 오차가 클 수록 과거 패턴으로 예상하기 어려운 값으로 이상일 가능성이 크다.
복원 기반(reconstruction-based)
특정 시점의 구간 $T_{i,l}$을 입력받아 더 작은 잠재 공간으로 압축한 뒤, 다시 원본으로 복원하도록 학습한다. 입력값과 복원값의 차이인 복원오차를 이상점수로 사용, 학습하지 않은 이상 패턴은 제대로 복원하지 못할 것이라고 가정한다.
위 사진은, 예측 기반 방법에서 실측 값을 언제 사용하는지에 따라 Forecasting First 와 Data First 로 구분한 것이다. 예보 기반 방법은 미리 예측한 값을 기반으로 실제 값과의 차이를 보기 때문에 Forecasting First에, 복원 기반 방법은 실제 값을 입력받아 압축 및 복원하는 작업이기 때문에 Data First에 가깝다.
이번 포스팅에서는 이상치의 정의와 특성, 그리고 시계열 이상 탐지의 핵심 개념을 살펴보았다. 다음 포스팅에서는 대표적인 준지도 · 예보 기반 이상 탐지 방법인 LSTM-based Anomaly Detection을 알아본다.
<References>
[1] Chandola, Varun, Arindam Banerjee, and Vipin Kumar. "Anomaly detection: A survey." ACM computing surveys (CSUR) 41.3 (2009): 1-58.
[2] https://www.lancaster.ac.uk/stor-i-student-sites/harini-jayaraman/anomaly-detection/ (2026.08.04)
[3] Boniol, Paul, et al. "Dive into time-series anomaly detection: A decade review." arXiv preprint arXiv:2412.20512 (2024).
[4] Malhotra, Pankaj, et al. "Long short term memory networks for anomaly detection in time series." Esann. Vol. 2015. No. 89. 2015.
- [1] 1.1 참조. [본문으로]
- [1] Anomaly detection: A survey. (2009) [본문으로]
- [3] Dive into time-series anomaly detection: A decade review. (2024) [본문으로]
- [2] Types of Anomalies [본문으로]
- [3] 2.5 Anomaly Detection Pipelines 참조. [본문으로]
- [3] 3 Anomaly Detection Taxomonmy 참조. [본문으로]
- [4] Long short term memory networks for anomaly detection in time series (2015) [본문으로]
- [3] 9 Evolution of Methods over Time: A Meta-Analysis 참조. [본문으로]
- [1] 하지만, 항상 희귀한 것은 아니라고 덧붙이고 있음. [본문으로]
- [1] 1.1 참조. [본문으로]
- [3] 28p, Table 3 참조 [본문으로]
- [3] 3 Anomaly Detection Taxomonmy 참조. [본문으로]
- [3] 3.0.3 Prediction-based. 참조. [본문으로]
'지식창고 > anomaly detection (이상치 탐지)' 카테고리의 다른 글
| [anomaly detection] Long Short Term Memory Networks for Anomaly Detection in Time Series (2015) (0) | 2026.08.24 |
|---|